Dify 知识检索性能优化(二):让评分与引用组装少做无用功
从 Grafana Tempo 的检索追踪出发,按需准备查询向量、精简引用文档查询,并用回归测试守住评分、排序和元数据。
阅读全文 ↗:Dify 知识检索性能优化(二):让评分与引用组装少做无用功从 Grafana Tempo 的检索追踪出发,按需准备查询向量、精简引用文档查询,并用回归测试守住评分、排序和元数据。
阅读全文 ↗:Dify 知识检索性能优化(二):让评分与引用组装少做无用功workflow_started 平均耗时下降 41.3% 的环境样本背后,是请求内模型信息复用、供应商声明缓存,以及需要认真处理的失效边界。
阅读全文 ↗:让 Dify Chatflow 更快开始:一次启动阶段的性能优化模型还在 worker 上运行,管理状态却可能已经丢失。串起 PR #4731 与 #5250,理解副本状态回放、幂等注册,以及旧 Actor 引用为什么会阻断恢复。
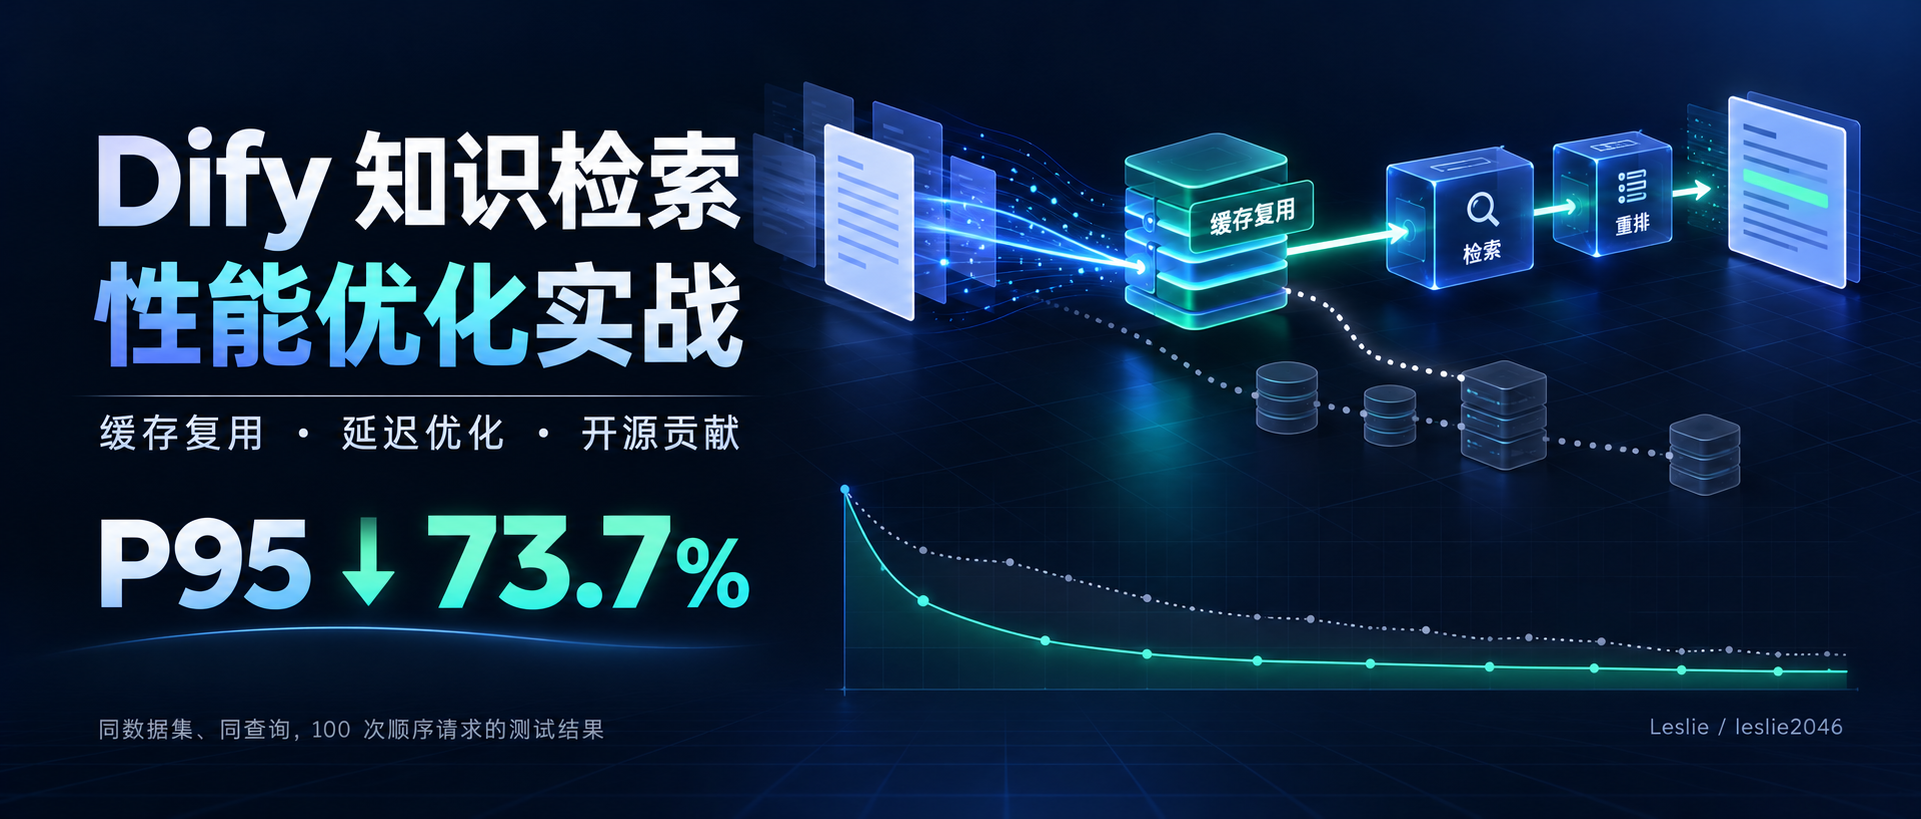
阅读全文 ↗:Xinference Supervisor 重启之后:从模型副本重建到真正的重连从模型供应商声明缓存、查询向量的延迟初始化到重排信息复用,记录一次真实的检索链路优化与长尾延迟思考。
阅读全文 ↗:Dify 知识检索性能优化(一):一次 P95 延迟下降 73.7% 的实践没有找到匹配的文章,试试其他关键词。
持续记录,慢慢积累。
性能测试、部署对比与数据分析。保留测试条件、关键结果和结论边界。