优化 AI 应用的响应速度时,注意力很容易集中在模型和提示词上。但知识库检索与智能体工作流也依赖数据存储,数据卷所在的磁盘同样值得检查。
一次将 Dify 与 RAGFlow 核心数据卷从机械硬盘(HDD)迁到固态硬盘(SSD)的测试,记录到了三条路径的耗时下降:RAGFlow 检索、Dify 检索,以及 Dify Agent 的端到端调用。其中,Agent 平均总耗时从 8.77 秒降到 6.34 秒,减少约 2.42 秒。
这个结果提供了一个具体的优化线索。理解它的前提,是把存储迁移、测量指标和样本规模放在一起看。
测试覆盖了哪些路径
测试于 2026 年 6 月 10 日进行。迁移对象是 Dify 与 RAGFlow 卷中的相关核心数据,迁移前后分别使用 Python 脚本调用检索接口与智能体应用。三个场景在迁移前后各记录 10 轮,总计 60 条调用记录;各组日志均记录 10 次成功、0 次失败。
| 场景 | 测量对象 | 数据或请求范围 |
|---|---|---|
| RAGFlow 知识库检索 | 检索调用延迟 | 固定问题;每轮日志均记录 chunks=30、total=90 |
| Dify 知识库检索 | 检索调用延迟 | 约 5000 条数据,固定查询 |
| Dify Agent | 工作流启动、首字响应与总耗时 | 固定查询,记录 started、ttft、total |
这是一次具体部署环境中的前后对比。10 轮调用不能直接等同于并发压测,两个系统使用的知识库与查询也不同,因此不能用这组数据判断 Dify 和 RAGFlow 谁更快。
检索平均耗时下降 高分位变化更明显
绿色高亮标注同一指标在 HDD 与 SSD 两组中的最低耗时,降幅和减少时间列不参与比较。下面沿用报告汇总表中的指标,单位均为毫秒。耗时降幅按 (迁移前 − 迁移后) / 迁移前 计算。
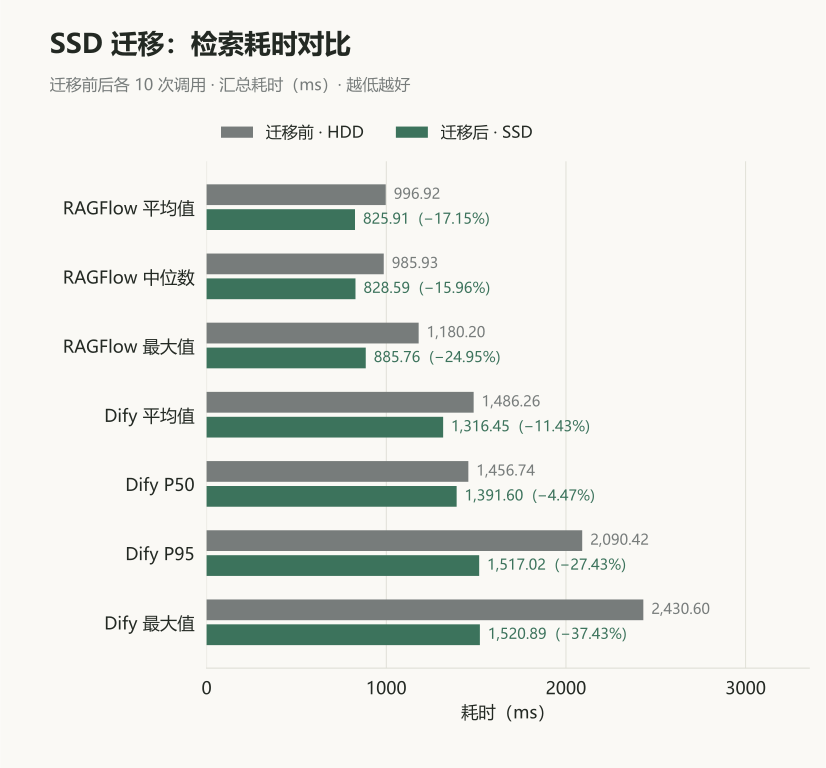
柱长从零开始,越短表示耗时越低;绿色柱旁标出迁移后的耗时与降幅。各指标沿用下表的汇总值,每组 10 次调用。点击图表可放大查看。
| 场景与指标 | HDD | SSD | 耗时降幅 |
|---|---|---|---|
| RAGFlow 平均值 | 996.92 | 825.91 | 17.15% |
| RAGFlow 中位数 | 985.93 | 828.59 | 15.96% |
| RAGFlow 最大值 | 1180.20 | 885.76 | 24.95% |
| Dify 平均值 | 1486.26 | 1316.45 | 11.43% |
| Dify P50 | 1456.74 | 1391.60 | 4.47% |
| Dify P95 | 2090.42 | 1517.02 | 27.43% |
| Dify 最大值 | 2430.60 | 1520.89 | 37.43% |
RAGFlow 的平均检索耗时减少约 171 毫秒,中位数也有相近方向的变化。迁移后的 10 个样本落在 772.69 至 885.76 毫秒之间;迁移前则在 914.97 至 1180.20 毫秒之间。两组样本范围在这次测试中没有重叠。
Dify 的平均耗时减少约 170 毫秒,但中位数只下降 4.47%。更显著的变化发生在样本中较慢的调用:P95 减少约 573 毫秒,最大值减少约 910 毫秒。
这种差异比一个“整体提速百分比”更有信息量:在这批 Dify 请求里,迁移后的收益更多体现在较慢的样本上。它支持继续观察高分位延迟,但不能据此宣称线上长尾已经消失。10 个样本中的最大值,只是这次测试观察到的最大值。
Agent 的收益不只出现在启动阶段
检索是应用路径中的一部分,Agent 调用更接近完整的交互过程。报告分别记录了工作流启动、首字响应(TTFT)和请求总耗时。
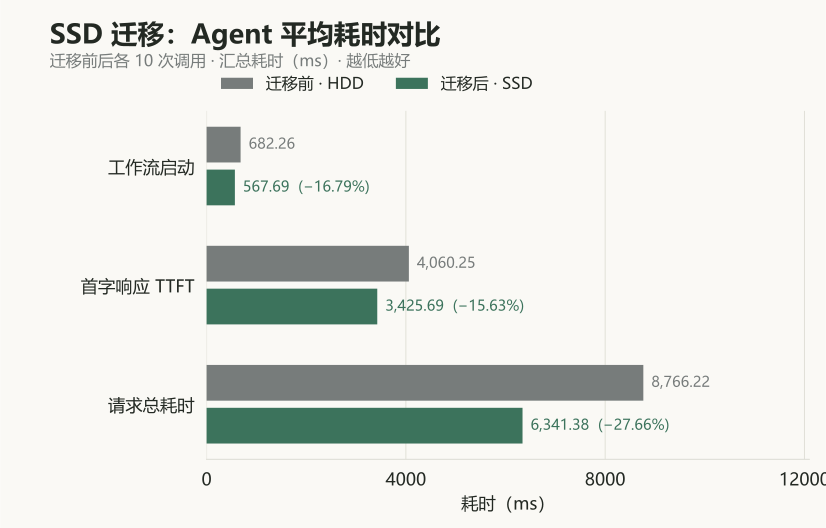
三项指标使用同一毫秒坐标轴,便于比较绝对等待时间;它们描述不同的计时范围,不能叠加为总耗时。
| Agent 平均指标 | HDD | SSD | 减少时间 | 耗时降幅 |
|---|---|---|---|---|
| workflow_started | 682.26 ms | 567.69 ms | 114.57 ms | 16.79% |
| TTFT | 4060.25 ms | 3425.69 ms | 634.56 ms | 15.63% |
| total | 8766.22 ms | 6341.38 ms | 2424.84 ms | 27.66% |
三项指标都下降了,但幅度不同。用户看到首字的平均等待时间减少约 0.63 秒,完整调用的平均等待时间减少约 2.42 秒。
这些指标描述不同的时点或范围,不能把三项减少时间直接相加,也不能把 workflow_started 当作 TTFT。测试命令没有附带完整脚本实现,因此这里保留日志中的指标名称,不进一步推断精确计时边界。
总耗时的减少明显大于启动阶段的减少,说明观察到的变化覆盖了更长的调用路径。存储等待可能影响其中的多个环节,但要把 2.42 秒逐一归因到数据库、检索、工具调用或模型生成,还需要节点级耗时与磁盘监控数据。
10 轮样本能回答什么
这组记录最直接的结论是:在此次环境和请求样本中,SSD 迁移后,三个场景的平均耗时均低于迁移前。 它值得作为后续部署与验证的依据,但还不足以给出稳定的容量或并发能力结论。
首先,P95 对小样本很敏感。将 Dify 的 10 个样本排序后,采用线性插值可以复算出报告中的 P95;这个数主要由最大的两个样本决定。一次较慢请求就可能显著改变结果,因此不能把它当作长期线上 P95 的估计。
其次,前后测试没有完整列出软件版本、磁盘型号、缓存预热方式、后台负载和并发参数。日志也没有提供 Agent 的输出长度与节点级耗时。数据说明迁移前后出现了变化,却不能排除缓存、环境负载或模型输出差异的影响,更不能断言所有差异都由磁盘造成。
最后,测试中的第 1 轮到第 10 轮是运行顺序,不是同一时刻或同一负载下的配对实验。比较分布与汇总指标,比逐轮相减更合适。
下一次测试如何补齐证据
如果要继续验证这次存储迁移的收益,我会先固定应用版本、知识库、查询与模型参数,并明确区分冷缓存和热缓存。随后增加重复测试批次,再分档提高并发,观察收益是否仍然存在。
测量时可以同时记录请求延迟、成功率、工作流节点耗时,以及磁盘 I/O 等待、吞吐和队列情况。这样,应用变快与存储等待减少是否同步,才有更直接的证据。Agent 场景还应记录输出长度,减少生成内容变化对总耗时比较的干扰。
这次测试让我更关注一件事:在修改应用代码之前,先检查它的数据存储路径。对于这套部署,SSD 迁移已经给出了值得继续验证的收益;接下来的工作,是通过更充分的样本和分层指标,把收益的来源与适用范围说明白。
数据与相关实践
本文依据《固态硬盘(SSD)迁移前后性能对比分析报告》V1.2,测试日期为 2026-06-10。表格使用报告汇总值;脱敏样本保留附录中的逐轮耗时,可用于复算。