---
title: 'P40 与 L20 上的 Embedding 和 Reranker 服务性能对比'
description: '比较 P40 + Xinference、L20 + Xinference 和 L20 + vLLM 三组部署,记录不同并发下的 QPS、P50 与 P95,以及单轮短测试的适用范围。'
date: 2026-10-11
tags: [Xinference, vLLM, Embedding, Reranker, GPU, 性能测试]
category: 性能测试
kind: report
references: /references/p40-l20-serving-sources/
download: /downloads/p40-l20-serving-benchmark.md
---
知识库应用的检索链路中,Embedding 和 Reranker 服务的响应速度会影响调用体验。硬件升级与服务部署方式都可能改变性能,测试时需要分别观察它们。
这份报告整理了 **P40 + Xinference、L20 + Xinference、L20 + vLLM** 三组部署的测试结果。在这批样本中,L20 + vLLM 的 Embedding 在并发 30 时达到 **1197.76 QPS**,Reranker 在并发 20 时达到 **310.71 QPS**。
这两个数是测试范围内观察到的峰值。各组仅运行一轮、每档 100 次请求,部分 vLLM 测试持续时间不足 0.5 秒,因此更适合用来寻找复测方向,不能直接当作长期服务容量。
## 测试矩阵与指标口径
原报告日期为 **2026 年 9 月 21 日**。三组部署使用相同的模型名称、并发档位和请求数量。
| 项目 | 测试设置 |
| --- | --- |
| 硬件与服务组合 | Tesla P40 + Xinference;L20 + Xinference;L20 + vLLM |
| Embedding 模型 | bge-m3 |
| Reranker 模型 | bge-reranker-large |
| 并发档位 | 1、5、10、20、30 |
| 每档请求数 | 100,单轮 |
| Reranker 脚本参数 | batch-size=0 |
| 延迟口径 | 客户端端到端观测,单位为毫秒 |
| 成功率 | 报告记录全部测试组为 100% |
QPS 表示报告中的每秒请求吞吐;P50 和 P95 分别描述延迟分布的中位数与高分位。QPS 的比较单位是请求,不能换算成 token 吞吐或重排文档对吞吐,因为输入长度和每次请求的文档数量没有完整记录。
L20 上两组部署使用同一台硬件,更适合观察部署方式的差异。不过,报告没有记录 Xinference 的实际推理后端、精度、worker 数量与版本,不能把全部差异归因到框架本身。P40 与 L20 的网络路径也不同,其对比反映的是完整服务栈表现。
结果表按同一并发档位横向比较:绿色高亮为最高 QPS,或同一延迟指标的最低值。P50 与 P95 分别比较,比值列不参与最佳值判定。
## Embedding 吞吐随并发增加
[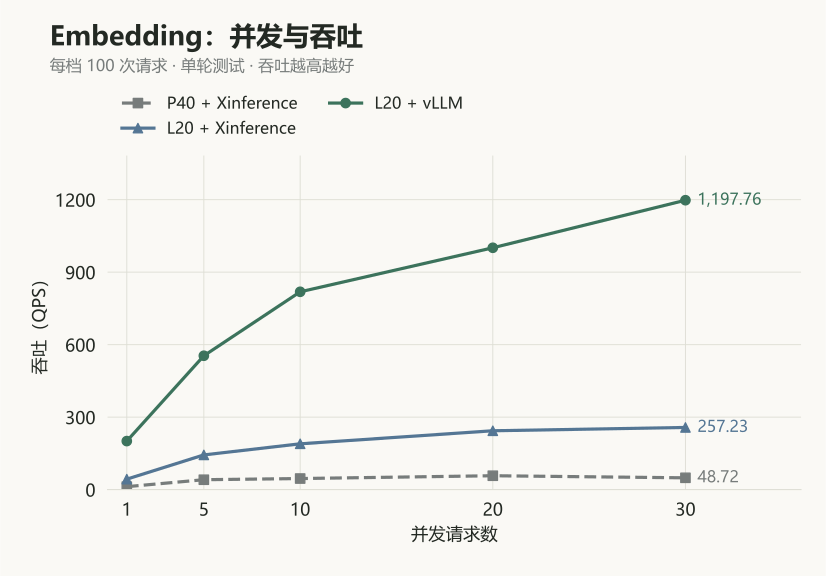](/images/reports/gpu-embedding-qps.svg)
横轴按实际并发数间隔绘制,纵轴从零开始。标记对应各档观测值,连线用于辨认变化方向;每档仅 100 次请求、单轮测试。点击图表可放大查看。
| 并发 | P40 + Xinference QPS | L20 + Xinference QPS | L20 + vLLM QPS | L20 同档 QPS 比值 |
| --- | ---: | ---: | ---: | ---: |
| 1 | 12.13 | 43.30 | 200.81 | 4.64 倍 |
| 5 | 40.91 | 143.62 | 554.01 | 3.86 倍 |
| 10 | 45.77 | 189.56 | 818.70 | 4.32 倍 |
| 20 | 57.39 | 243.51 | 1000.88 | 4.11 倍 |
| 30 | 48.72 | 257.23 | 1197.76 | 4.66 倍 |
表中的同档比值使用 `L20 vLLM QPS / L20 Xinference QPS` 计算。五档结果在 3.86 至 4.66 倍之间。
L20 + vLLM 的吞吐在测试范围内持续增加:并发从 20 增至 30,QPS 增加约 **19.7%**。由于没有测量更高并发,只能说当前范围内尚未观察到吞吐回落,不能确定真正的容量上限。
P40 + Xinference 则在并发 20 达到本轮峰值 57.39 QPS,升至 30 后降为 48.72 QPS。这个转折值得复测,但单轮数据不足以确定它来自硬件、排队、请求波动还是其他部署条件。
### L20 上的 Embedding 延迟
[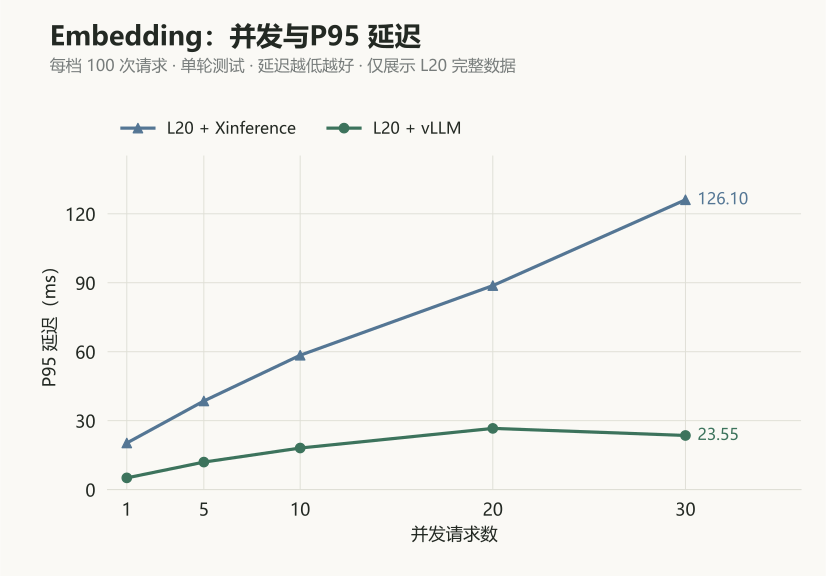](/images/reports/gpu-embedding-p95.svg)
延迟独立绘图,避免与 QPS 共用坐标轴。这里重点展示 P95;P50 的精确值保留在下表。P40 的延迟档位不完整,因此不绘制其延迟曲线。
| 并发 | Xinference P50 | vLLM P50 | Xinference P95 | vLLM P95 |
| --- | ---: | ---: | ---: | ---: |
| 1 | 19.64 ms | 4.79 ms | 20.27 ms | 5.10 ms |
| 5 | 34.30 ms | 8.60 ms | 38.56 ms | 11.97 ms |
| 10 | 51.44 ms | 11.56 ms | 58.46 ms | 18.09 ms |
| 20 | 79.21 ms | 16.23 ms | 88.76 ms | 26.63 ms |
| 30 | 109.52 ms | 20.44 ms | 126.10 ms | 23.55 ms |
在这批结果中,L20 + vLLM 在五档并发下同时获得更高 QPS 和更低 P50、P95。并发 30 的 P95 为 23.55 ms,反而低于并发 20 的 26.63 ms。这样的非单调变化需要更长测试来判断,不能据此认为继续提高并发会降低尾延迟。
## Reranker 在并发 20 附近出现吞吐平台
[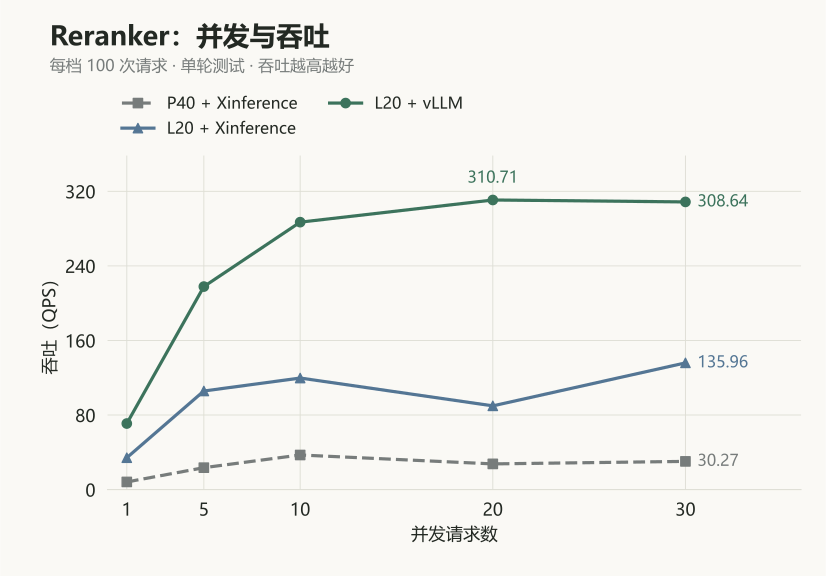](/images/reports/gpu-reranker-qps.svg)
并发 20 与 30 的 vLLM 观测点接近水平,能直观看到本轮吞吐平台;单轮连线不代表这些档位之间已经经过连续测试。
| 并发 | P40 + Xinference QPS | L20 + Xinference QPS | L20 + vLLM QPS | L20 同档 QPS 比值 |
| --- | ---: | ---: | ---: | ---: |
| 1 | 8.22 | 34.18 | 70.88 | 2.07 倍 |
| 5 | 23.51 | 105.80 | 217.81 | 2.06 倍 |
| 10 | 37.14 | 119.69 | 286.93 | 2.40 倍 |
| 20 | 27.57 | 89.84 | 310.71 | 3.46 倍 |
| 30 | 30.27 | 135.96 | 308.64 | 2.27 倍 |
Reranker 的曲线与 Embedding 不同。L20 + vLLM 在并发 20 时达到 310.71 QPS,并发 30 时为 308.64 QPS,相差约 **0.7%**。这两个档位的吞吐已经很接近。
### L20 上的 Reranker 延迟
[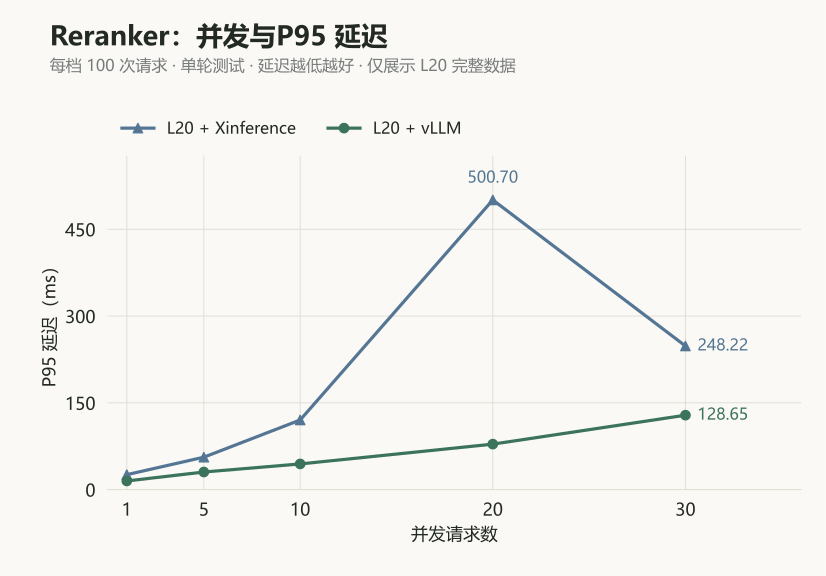](/images/reports/gpu-reranker-p95.svg)
与吞吐图一起看,并发 20 升至 30 时,vLLM 吞吐几乎不变,P95 仍继续上升。Xinference 在并发 20 的 500.70 ms 高值也按原数据保留,是否稳定出现需要复测。
| 并发 | Xinference P50 | vLLM P50 | Xinference P95 | vLLM P95 |
| --- | ---: | ---: | ---: | ---: |
| 1 | 25.13 ms | 14.59 ms | 25.85 ms | 14.93 ms |
| 5 | 53.81 ms | 20.96 ms | 56.04 ms | 30.42 ms |
| 10 | 77.88 ms | 33.33 ms | 120.34 ms | 44.38 ms |
| 20 | 146.42 ms | 59.92 ms | 500.70 ms | 78.61 ms |
| 30 | 224.58 ms | 89.53 ms | 248.22 ms | 128.65 ms |
并发从 20 增至 30 时,L20 + vLLM 的吞吐几乎没有增长,P95 却从 78.61 ms 增至 128.65 ms,增加约 **63.7%**。在这一轮样本中,继续增加并发的代价主要体现在延迟上。
因此,并发 20 可以作为 Reranker 下一轮复测的重点,而不是已经验证的生产最优值。如果业务有更严格的延迟要求,还需要同时观察较低并发档位。
## 同档比较与峰值比较需要区分
Reranker 的 **3.46 倍**,来自并发 20 时的同档比较:`310.71 / 89.84`。如果比较两组部署各自在测试范围内的最高 QPS,则为 `310.71 / 135.96`,约 **2.29 倍**。两个数字回答的是不同问题。
Embedding 的测试内峰值比为 `1197.76 / 257.23`,约 **4.66 倍**,恰好两组峰值都出现在并发 30。不能因为 Embedding 的两个口径重合,就在 Reranker 中也混用同档与峰值比值。
比较峰值能够描述各组在本次档位范围内的最高观测吞吐;选择服务参数还要一起看延迟、错误率和业务负载。
## 部署参数与复测范围
报告提供了 vLLM 的启动参数。两种模型都使用 float16、GPU 0、最大序列数 128,以及最大批 token 数 8192。Embedding 使用 pooling embed、最大序列长度 8192、显存利用比例 0.60;Reranker 使用 pooling classify、最大序列长度 512、显存利用比例 0.30。
两条原始命令复用了同一 GPU 和服务端口,报告要求分别启动。这里的结果不代表 Embedding 与 Reranker 同时运行时的共享资源表现。`batch-size=0` 是压测脚本传入的参数,也不代表已知服务端的实际动态批大小。
原报告建议每档至少 1000 次请求,预热后重复 3 至 5 轮。这可以作为复测的起点;若要验证持续容量,还需要让测试持续足够长,并覆盖真实输入长度与持续负载。
下一轮应补齐服务版本、推理后端、精度、模型版本、网络路径和预热记录,并同步观察 GPU 利用率、显存、队列与实际批大小。Embedding 可以继续测试并发 40、50、64,寻找吞吐平台;Reranker 则重点复测 10、20、30,确认延迟上升与吞吐平台是否稳定存在。
这次结果最有价值的地方,是把复测方向变得具体:**Embedding 继续寻找吞吐边界,Reranker 优先验证并发与尾延迟的权衡。** 它还不是采购结论,也没有比较模型效果;生产选择仍需要真实负载下更完整的证据。
## 数据下载与来源
- [下载 30 组测试汇总 CSV](/downloads/p40-l20-serving-results.csv)
- [报告来源与指标核对记录](/references/p40-l20-serving-sources/)
- [SSD 迁移性能报告](/posts/ssd-migration-performance/)
CSV 为原报告中的测试组汇总值,不是逐请求日志。部署地址已省略。